
3.2 模型
模型是平台一切 AI 能力的底座:应用对话、知识库向量化、召回重排序,用的都是这里接入的模型。本章面向平台管理员,介绍「渠道 + 模型」两级接入结构的配置方法、可见范围控制与额度管理。
使用管理员账号登录,进入侧边栏「模型渠道」菜单。
渠道与模型的两级结构
- 渠道对应一个模型服务入口:选择对话协议,填入服务端点与密钥。一个渠道可以承载该服务下的多个模型;
- 模型挂在渠道之下,是应用与知识库实际选用的对象,按用途分为文本、向量、重排序、生图、视频、语音六种类型。
只要服务兼容 OpenAI 接口,就能接入:vLLM、Ollama、LM Studio 等自建推理服务,以及各大模型平台的 OpenAI 兼容端点都走 OpenAI ChatCompletions 协议;平台同时支持 OpenAI Responses、Anthropic Messages、Google Gemini 三种协议。
「模型渠道」页以渠道为行、可展开查看渠道下的全部模型:
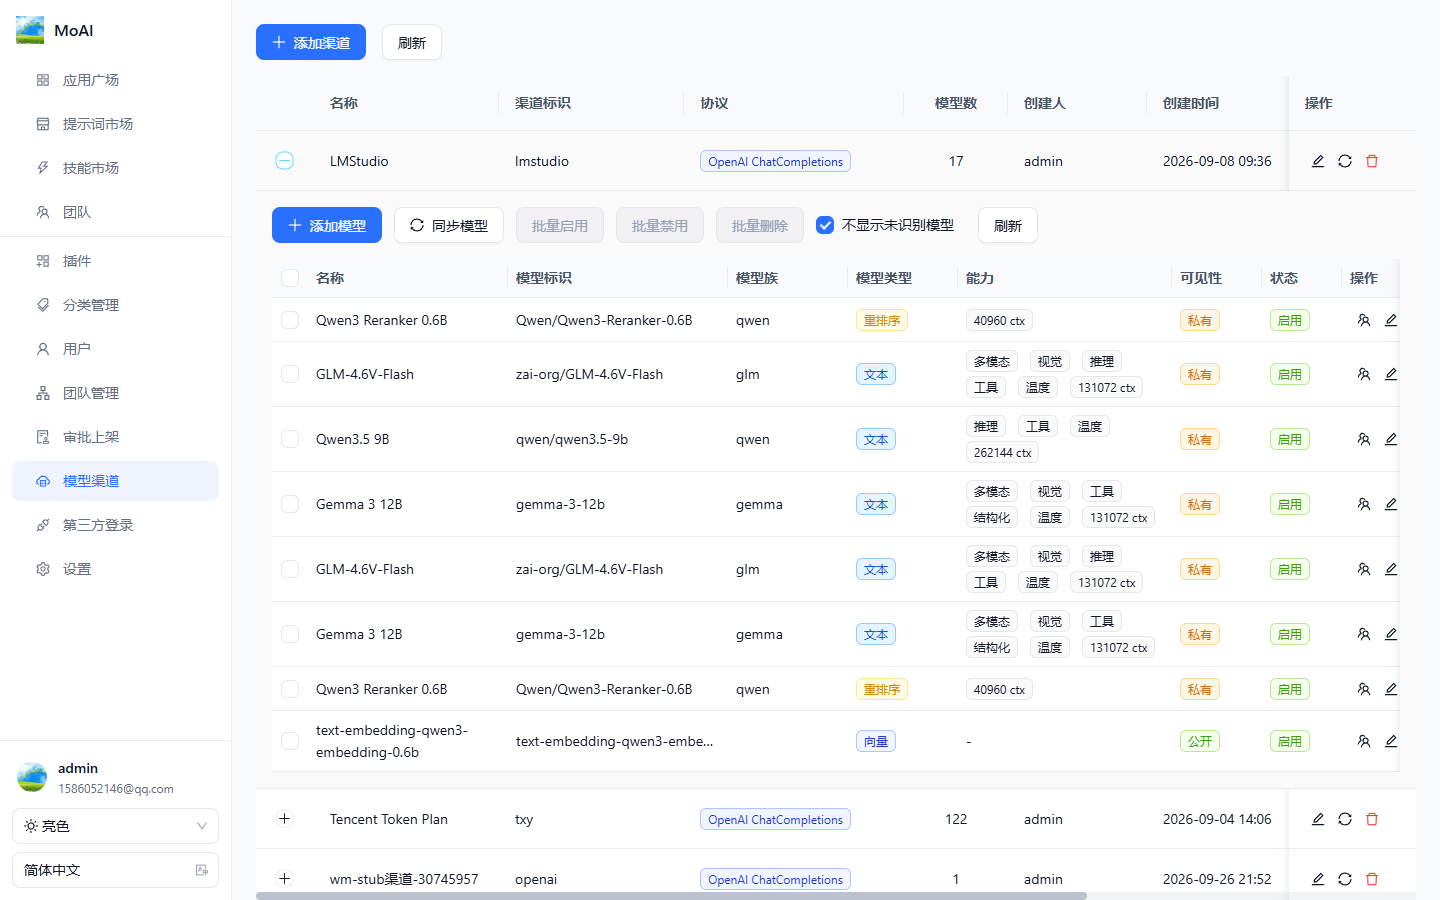
渠道行展示名称、渠道标识、协议、模型数与启停状态,行操作有三个:
| 操作 | 说明 |
|---|---|
| 编辑 | 修改渠道配置;密钥留空表示保持不变 |
| 同步模型 | 调用渠道的模型清单接口,自动把服务上的模型登记进来 |
| 删除 | 移除渠道及其下的模型登记(不影响模型服务本身) |
添加渠道
点击「添加渠道」:
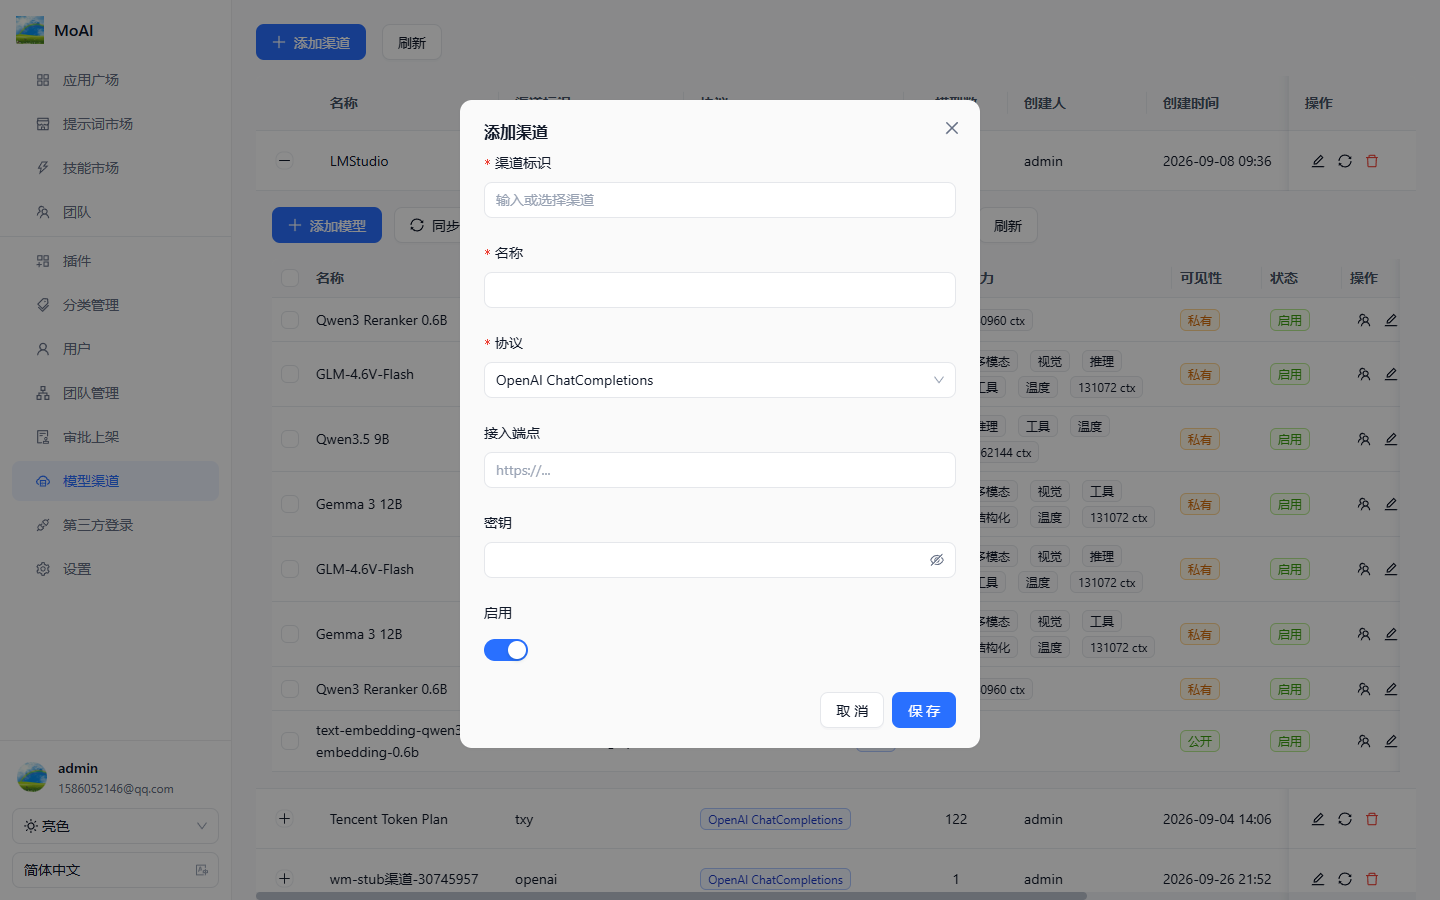
| 字段 | 说明 |
|---|---|
| 渠道标识 | 服务商标识,可从预置目录中选择,也可自定义;创建后不可修改 |
| 名称 | 渠道显示名,建议带上用途或环境(如「腾讯 MaaS-生产」) |
| 协议 | OpenAI ChatCompletions / OpenAI Responses / Anthropic Messages / Google Gemini 四选一 |
| 接入端点 | 服务地址(BaseAddress),如 https://...;本地推理服务填内网地址 |
| 密钥 | 服务商 API Key;编辑渠道时留空则保持原密钥不变 |
| 启用 | 关闭后渠道整体停用,其下所有模型不再可用 |
操作示范(接入一个 OpenAI 兼容渠道):
- 在服务商控制台创建 API Key;
- 点击「添加渠道」,协议选 OpenAI ChatCompletions;
- 填入接入端点(注意与服务商文档核对,通常到
.../v1这一级)与密钥,保存; - 展开渠道行,点击「同步模型」,平台自动拉取该服务的模型清单并登记;
- 对同步进来的模型逐一确认类型与能力(见下节),启用后即可在应用中使用。
登记模型
除「同步模型」自动登记外,也可以点击「添加模型」手动登记:
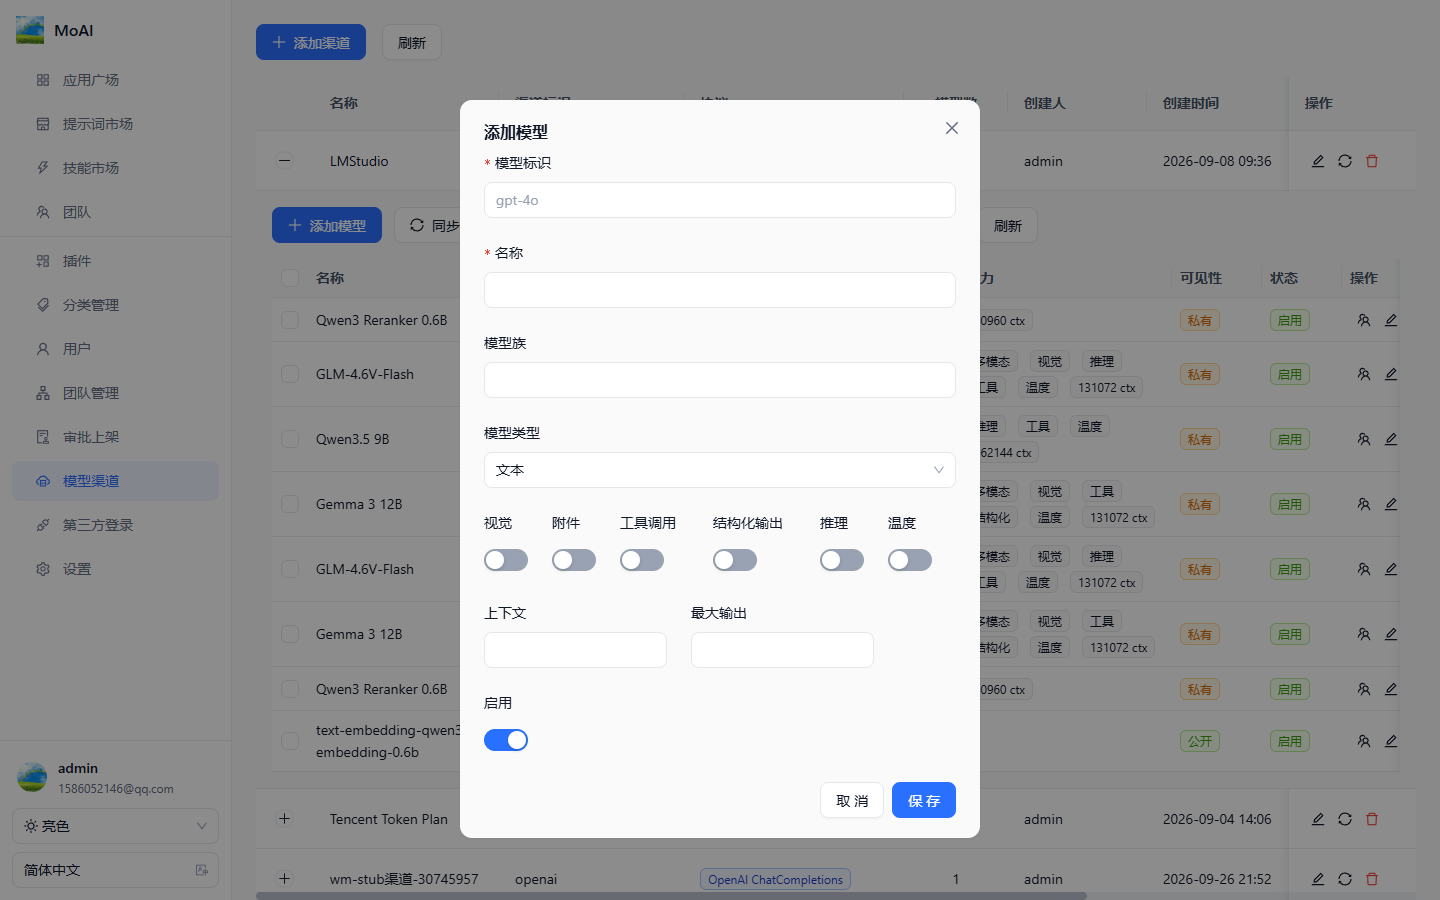
| 字段 | 说明 |
|---|---|
| 模型标识 | 调用时的真实模型名,必须与服务端的模型 ID 完全一致(如 gpt-4o) |
| 名称 | 显示名,应用与知识库的选择列表里看到的是它 |
| 模型族 | 可选,便于归组识别(如 qwen、glm) |
| 模型类型 | 决定用途:文本用于应用对话;向量用于知识库向量化;重排序用于检索重排序;另有生图、视频、语音 |
| 能力开关 | 随模型类型变化(视觉、附件、工具调用、结构化输出、推理、温度等)。声明了「工具调用」的模型才能在 Agent 应用里调用插件;「视觉」决定能否看图。按服务商的能力说明如实勾选 |
| 上下文 / 最大输出 | 模型的上下文窗口与单次最大输出 token 数,用于展示与校验 |
同步进来的模型若尚未确认类型与能力,会作为「未识别模型」默认隐藏;取消勾选「不显示未识别模型」可查看它们,补全类型后启用。列表还提供批量启用、批量禁用、批量删除,适合同步大量模型后的整理。
可见性与团队授权
模型默认私有——只有被授权的团队可用;开启「公开模型」后所有团队可用。私有模型的行操作里有「授权与额度」:
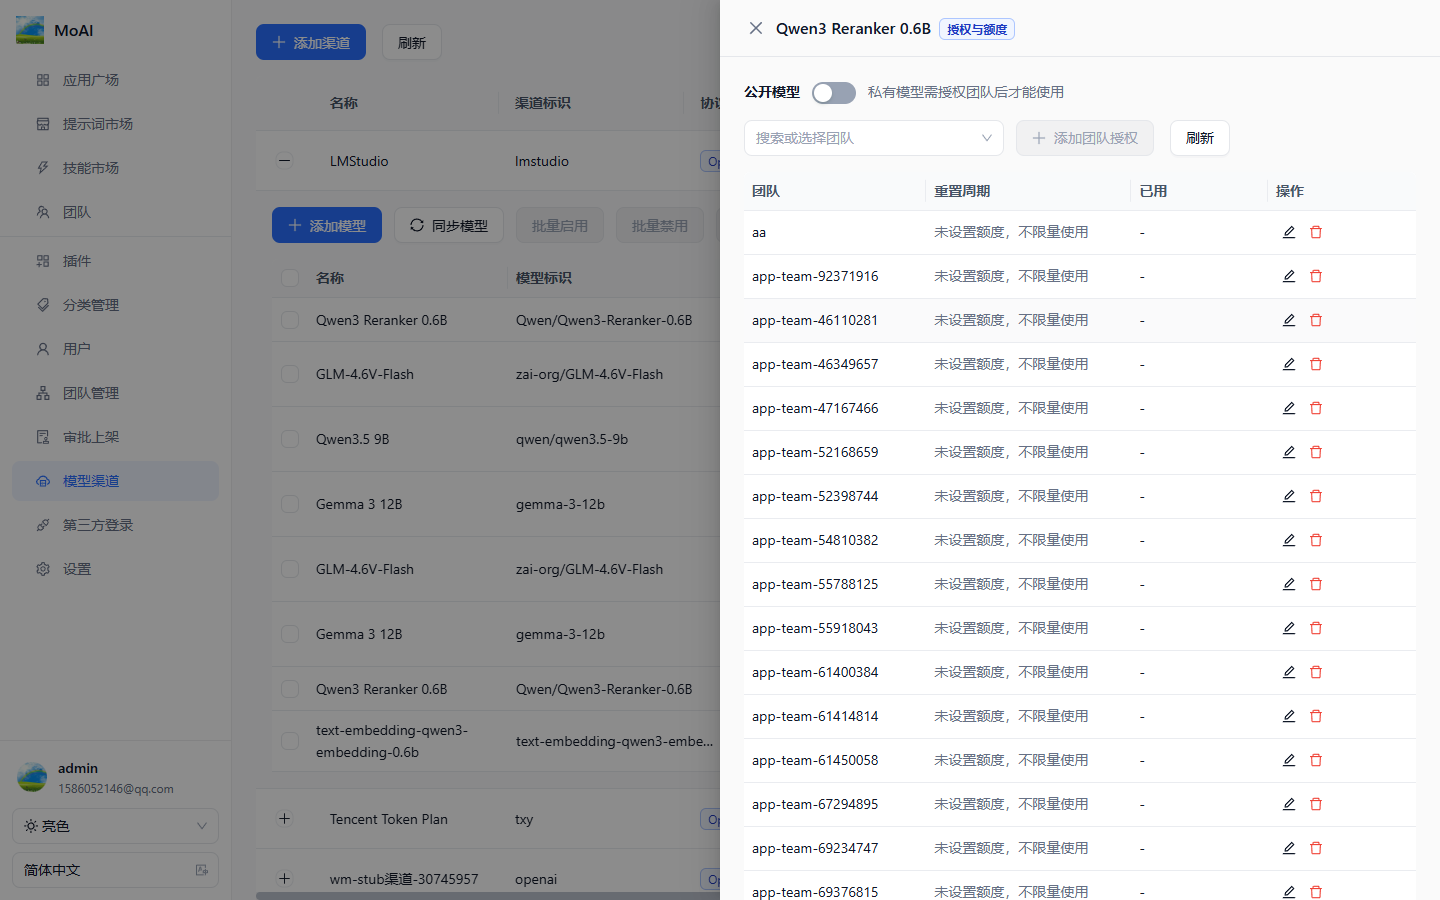
- 添加团队授权:搜索并选择团队,授权后该团队的应用、知识库即可选用此模型;
- 按团队设额度:为每个授权团队设置周期 tokens 上限(按小时 / 天 / 周 / 月重置,或一次性总量),超出后团队对本模型的使用受限;「已用」列实时累计消耗;
- 移除授权:团队立即失去该模型使用权,其额度规则一并清除;
- 全局额度:不区分团队、所有团队共享的总量额度,适合按合同采购的总量控制。
常见组合:向量、重排序这类内部基础模型设为公开,省去逐团队授权;对话模型按团队授权并配额度,控制各部门用量。
案例:给知识库配齐三件套
市场部要建产品知识库并上线一个客服 Agent,管理员这样把模型配齐:
- 文本模型:确认渠道里的对话模型已启用、勾选「工具调用」(Agent 要调插件),在「授权与额度」里授权市场部并设置每月额度;
- 向量模型:向量模型设为公开,所有团队的知识库都能直接用;
- 重排序模型:重排序模型设为公开,市场部在知识库召回测试里启用重排序提升命中质量。
三件套就绪后,市场部在团队里建知识库(选向量模型)、创建客服 Agent(选文本模型)即可开工。团队侧如何选用见 3.5 知识库 与 3.8 Agent 应用。
常见问题
对话没有任何回复?
先查渠道连通性(接入端点网络可达、密钥有效);再确认模型类型是否选对(对话要用「文本」类型);思考型模型在默认参数下可能返回空内容,可在渠道参数中关闭思考输出后重试。
应用里看不到某个模型?
三步排查:模型状态是否「启用」;可见性是否「私有」而当前团队未被授权;模型所在渠道是否被停用。
修改了渠道密钥,需要逐个改模型吗?
不需要。密钥属于渠道,改一处全部模型生效;编辑渠道时密钥留空表示保持不变。
同步出来一堆看不懂的模型?
同步按渠道清单全量登记,取消勾选「不显示未识别模型」可以核对原始清单;确认类型与能力后启用需要的,其余保持隐藏或批量删除即可。
渠道挂了会影响什么?
该渠道下所有模型不可用。已配置降级的环节(如召回重排序)会自动跳过继续执行,但应用对话会失败——重要场景建议接入两个渠道互为备份。