
3.5.1 文档处理和向量化
知识库的价值在于「问得出来、答得上去」,而决定检索质量的是入库前的处理链路:内容提取 → 文档切割 → 元数据生成 → 向量化。本章按这条链路逐段讲清每个环节做什么、参数怎么定,帮你把一份文档变成可被精准召回的知识。
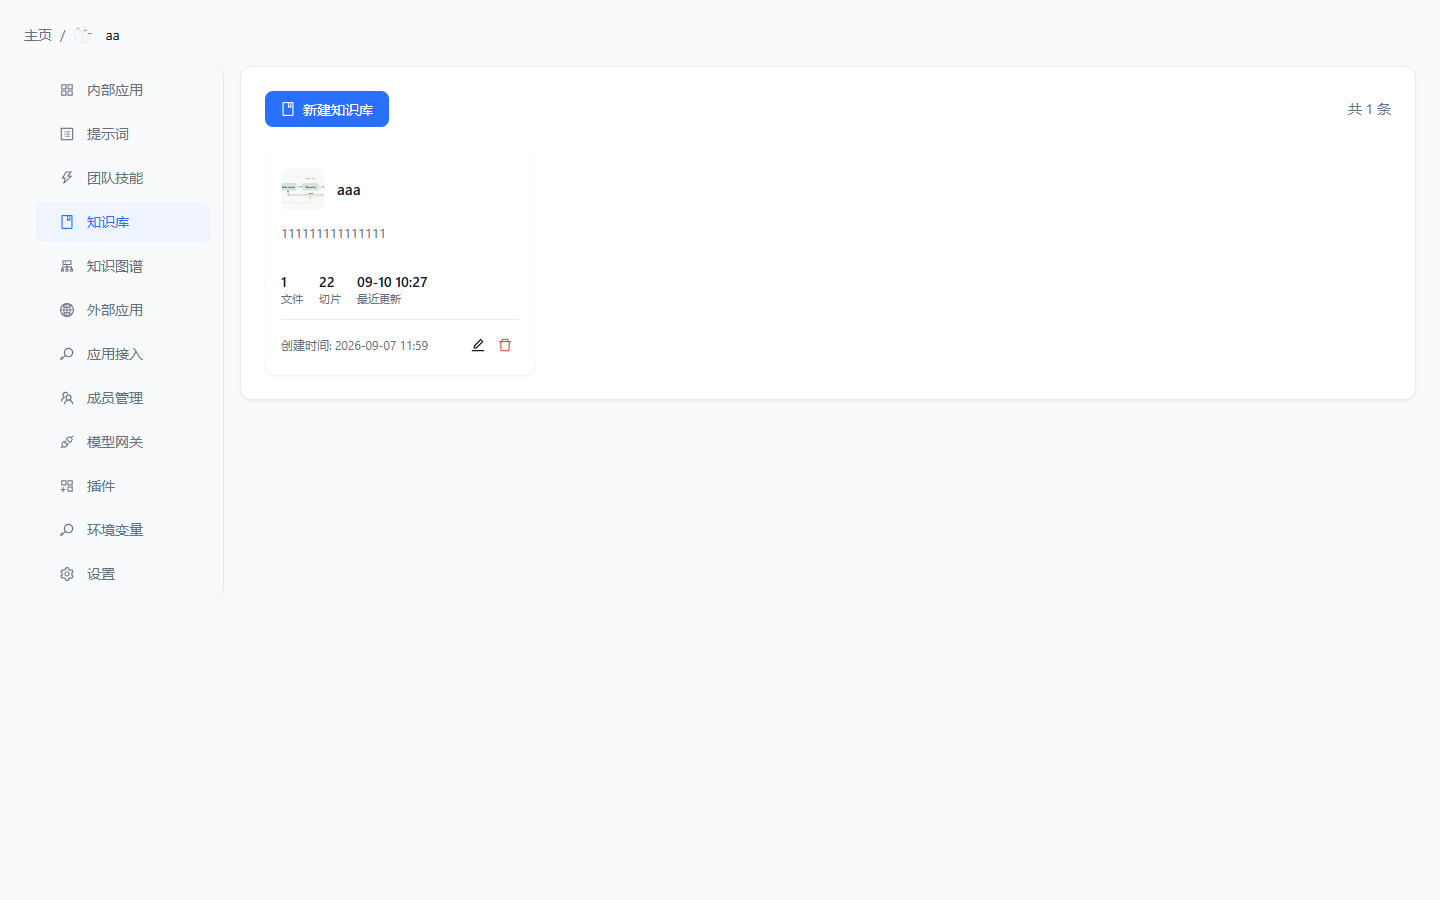
入口在团队空间的「知识库」菜单。一个团队可以建多个知识库(比如「产品文档」「制度合集」分开建),列表会显示每个库的文件数、切片数与最近更新:
上传文档
进入知识库的「文件列表」,点击「上传文档」,支持 PDF、Word、TXT、Markdown 等格式,拖拽批量上传:
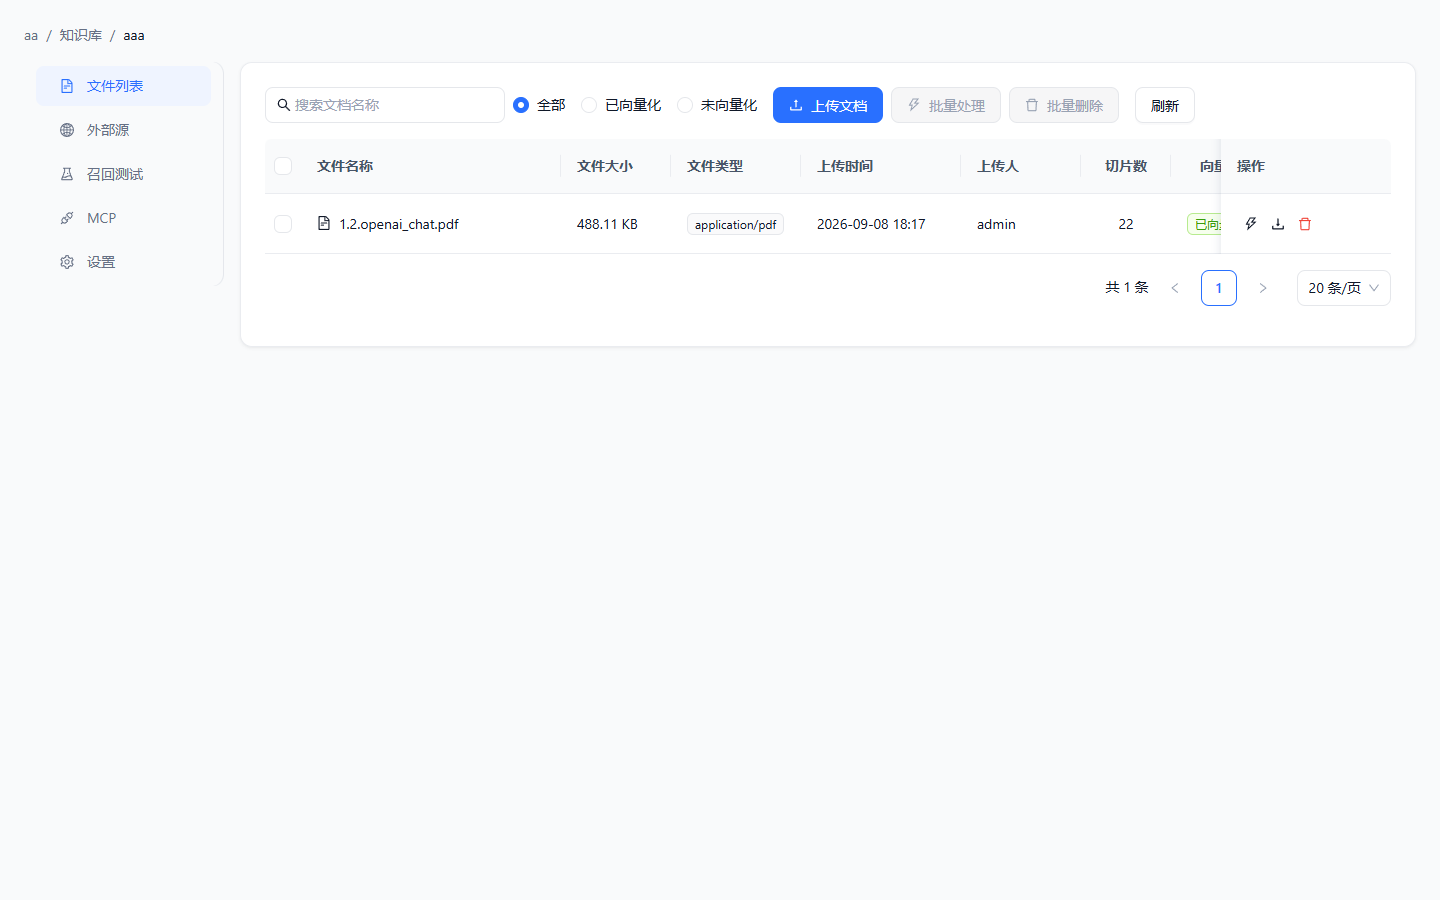
列表按「全部 / 已向量化 / 未向量化」筛选,每个文档显示切片数与向量化状态;「批量处理」可对多个文档批量执行工作流,「批量删除」清理文档。
内容提取
上传后平台先把文档解析成纯文本(PDF、Word 统一提取为 Markdown 风格文本),点开文档的「向量化」操作可以看到提取结果:内容字数、「查看内容」预览全文、「重新提取」在解析异常时重跑:
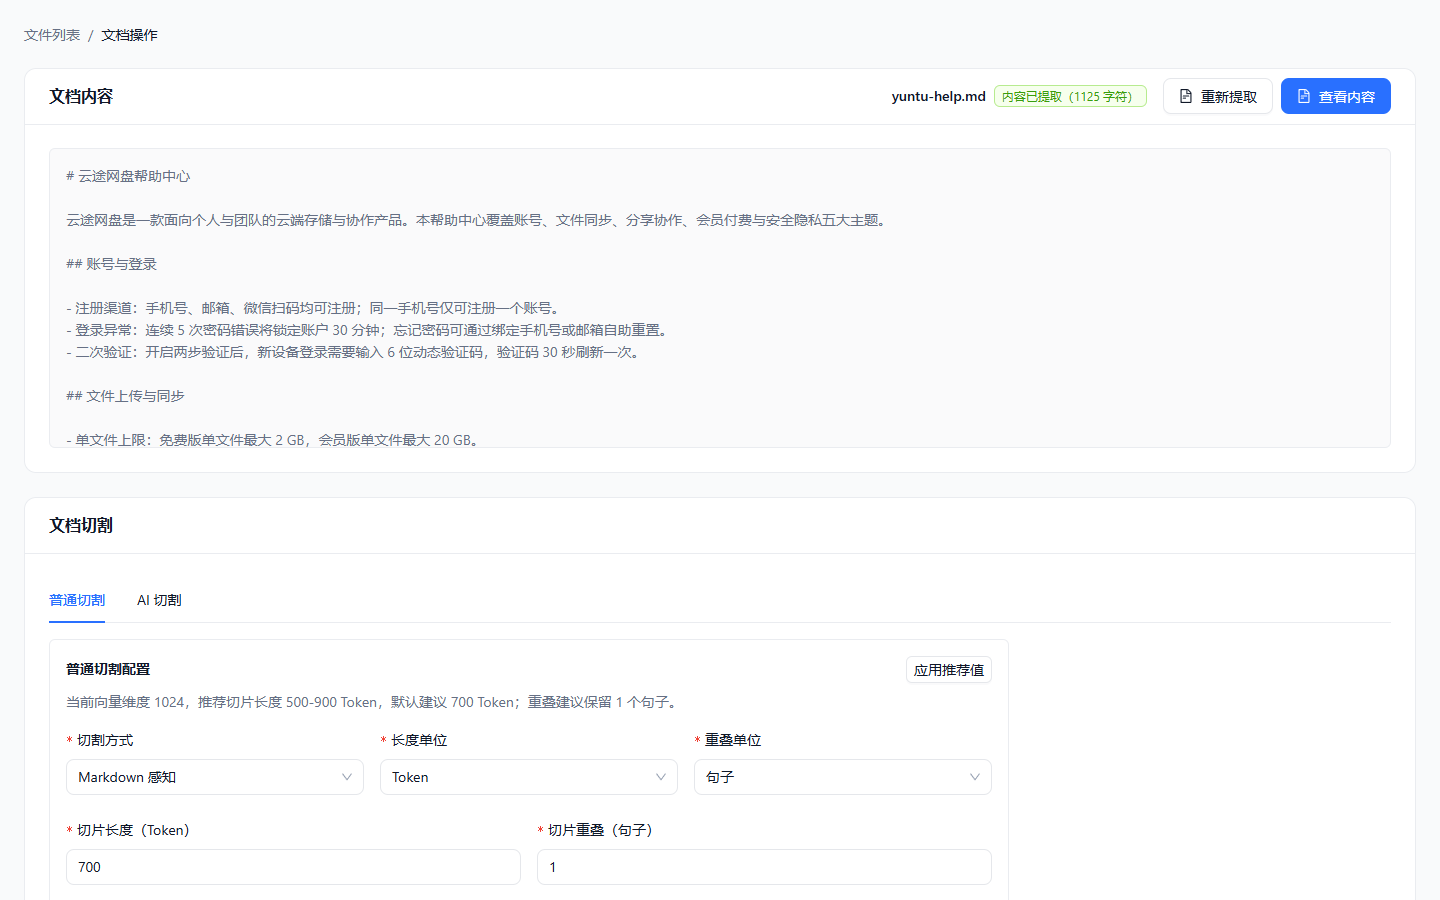
提取是切割的前提——提取失败(如加密 PDF、扫描件)时后面的环节都无法执行。
文档切割
切割把长文本切成适合检索的小片段。平台提供两种方式:
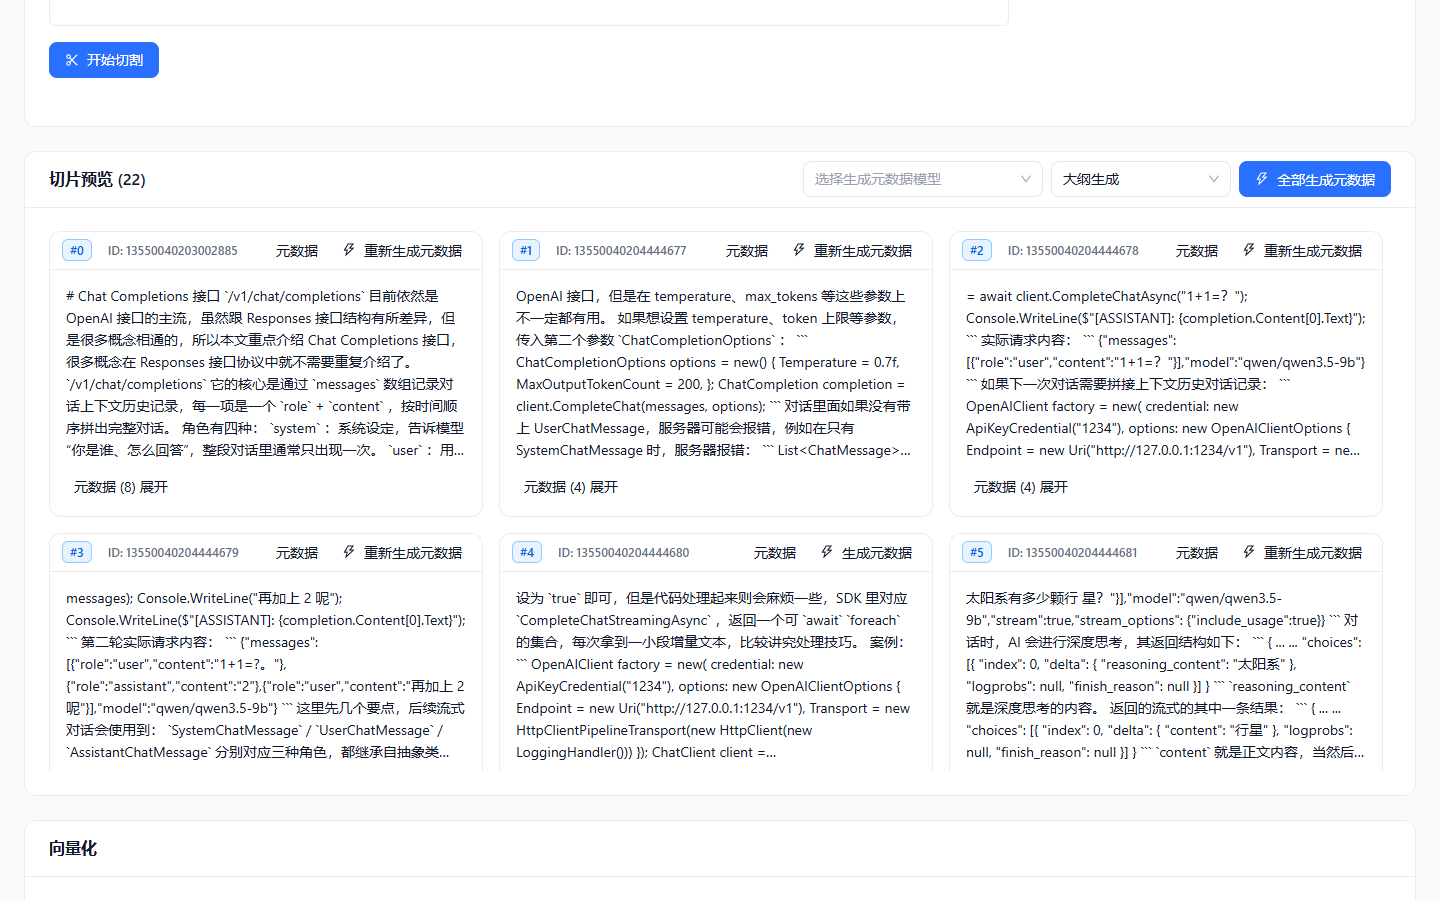
- 普通切割:按规则机械切分,快而稳定。三个关键参数:
- 切割方式:推荐 Markdown 感知——优先按标题、段落边界切,不会把一个章节拦腰斩断;
- 切片长度:按 Token 计。页面会根据当前向量模型给出推荐值(如「推荐切片长度 500-900 Token,默认建议 700」),不确定就用「应用推荐值」;
- 切片重叠:相邻片段重复的部分(如保留 1 个句子),避免关键句恰好被切断导致两边都召回不到。
- AI 切割:交给模型按语义切分,适合结构混乱的文档,耗时且有模型调用成本。
点击「开始切割」后页面实时生成「切片预览」,逐片检查内容是否完整:
元数据生成
切片只是原文片段,检索时用户的问题和片段的字面往往对不上(问「退货要钱吗」,片段里写的是「退货运费承担规则」)。元数据就是给每个切片补充检索面:选择一个对话模型后「全部生成元数据」,模型为每个切片生成大纲、摘要、假设问题、关键词等附加内容,之后可与原文一起参与向量化。
元数据显著提升问法自由度大的知识库(客服 FAQ、制度问答)的命中率;条目化强的文档(手册、表格)收益较小,可以只在「向量化」时勾选原文切片。
向量化
向量化把切片(和元数据)转成向量存入向量库,是检索的基础:
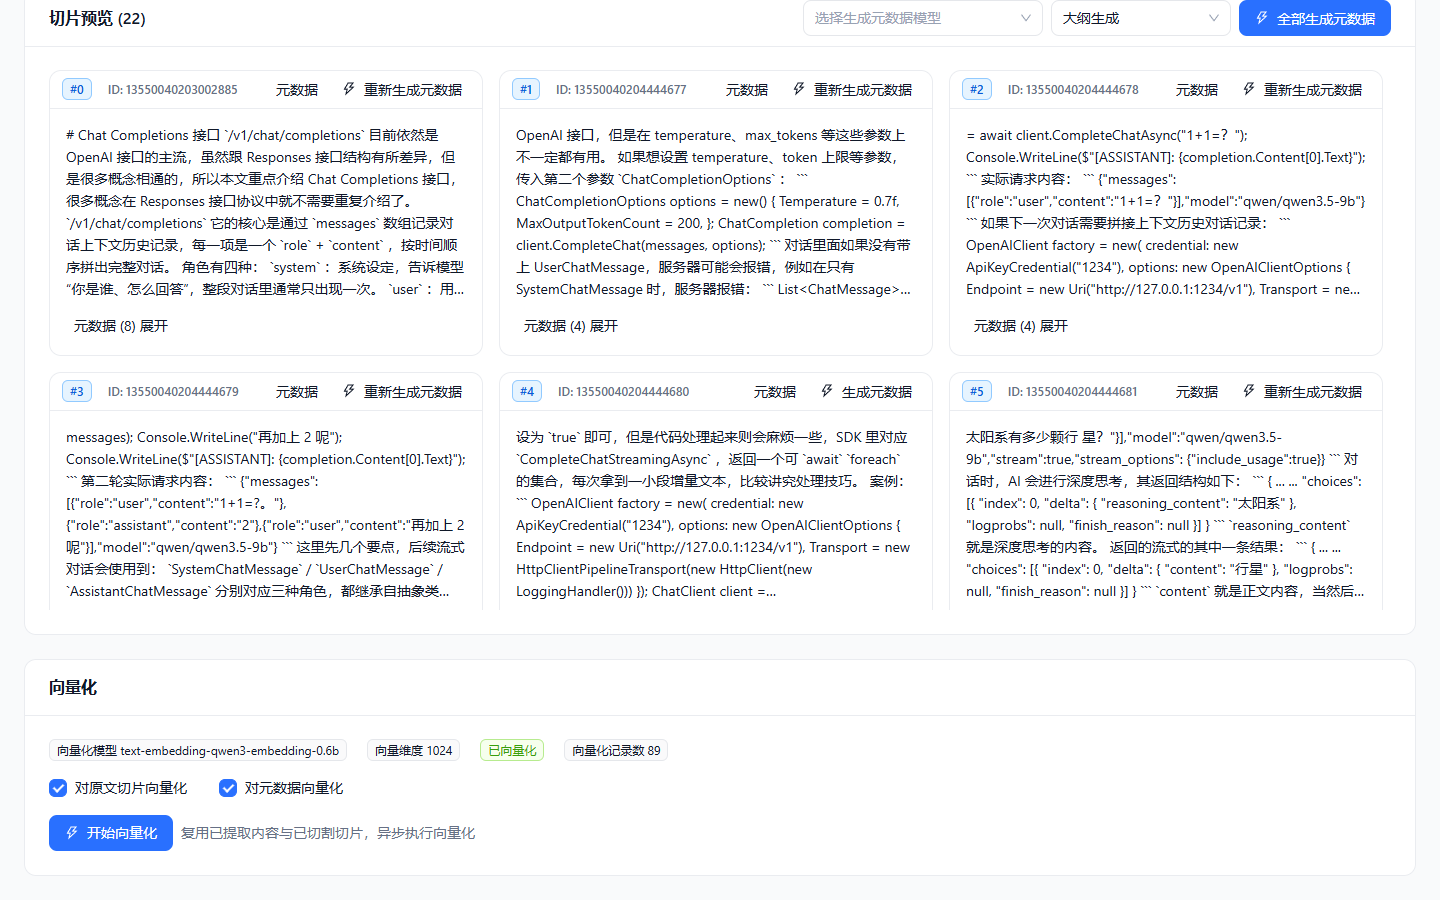
- 向量模型:在知识库「设置」中选择团队可用的向量模型(如腾讯渠道的
kinfra-text-embedding-4b)。模型与维度一旦完成向量化即锁定——之后更换模型需要清空重建,选型时一步到位; - 向量维度:与所选模型匹配(如 Qwen3-Embedding 系列为 1024),最大 2000;
- 向量化范围:按需勾选「对原文切片向量化」与「对元数据向量化」(勾选元数据前需已生成元数据);
- 点击「开始向量化」后任务异步执行,进度见状态标签与向量化记录数。
召回测试
入库完成后,用「召回测试」验证效果——这是调参的主工具:
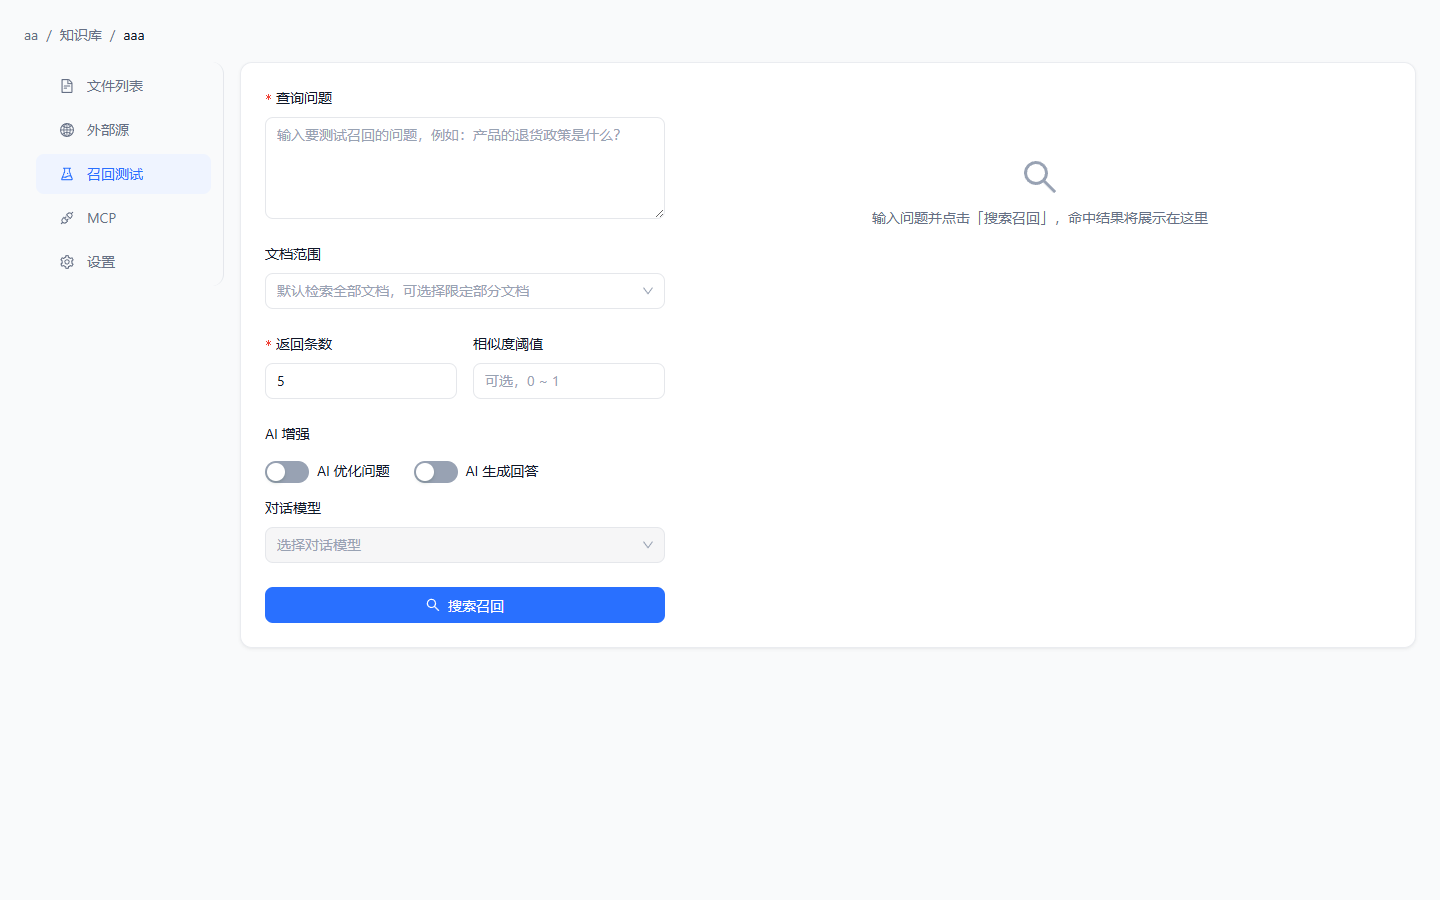
输入真实用户会问的问题,设置参数后点「搜索召回」:
| 参数 | 建议 |
|---|---|
| 返回条数 | 默认 5;知识量大时可加大到 10 再靠重排序压缩 |
| 相似度阈值 | 0 ~ 1,调高可过滤低质量命中;先留空观察原始得分分布再定 |
| 文档范围 | 可限定只检索部分文档,适合排查某个文档的召回情况 |
| AI 优化问题 | 开启后模型先把问题改写得更利于检索,适合口语化提问场景 |
| AI 生成回答 | 开启后基于召回内容直接生成答案,验证「召回 → 回答」全链路 |
结果列表展示每个命中片段的相似度、重排分与片段序号,相邻片段会自动做上下文合并。如果该知识库配置了重排序模型,结果会先经重排序再输出。
案例:把产品帮助中心变成智能问答底座
以一个「云途网盘帮助中心」知识库为例走一遍全流程(本章截图即来自该库):
- 建库:团队空间新建知识库「云途网盘帮助中心」,在设置里选定向量模型(腾讯渠道
kinfra-text-embedding-4b,维度 1024); - 入库:上传整理好的帮助文档 Markdown,检查内容提取字数正常;
- 切割:用推荐值(Markdown 感知 / 700 Token / 重叠 1 句)开始切割,切片预览确认每片主题完整;
- 生成元数据:选一个对话模型「全部生成元数据」,为切片补假设问题与摘要——帮助中心问答口径多变,元数据收益明显;
- 向量化:勾选原文切片 + 元数据,开始向量化;
- 验证:在召回测试里用真实用户口吻提问(「会员能退款吗」「文件误删了怎么找回」),确认每问的前 3 条命中都指向正确章节,再交付给应用使用。
常见问题
切片切多大合适?
没有万能值。经验起点是推荐值(500-900 Token);碎片化严重就调大,答非所问、上下文不足就调小并加大重叠。调整后用召回测试对比命中率,不要凭感觉定。
向量化模型能换吗?
知识库一旦有文档完成向量化,模型与维度即锁定;要换模型需要新建知识库重新走一遍入库流程。选型时优先确认模型支持指定维度参数。
向量化任务一直不完成?
打开文档的向量化页查看记录数;若任务失败会停留在未向量化。常见原因:向量模型渠道不可达、模型不支持平台传递的维度参数(渠道报「dimensions is not supported」时需更换支持维度参数的向量模型)、或切片为空。
召回测试命中了但应用里答不准?
先看应用绑定的知识库和参数是否一致(topK、阈值、重排序);再确认命中的片段确实包含答案——召回对了答不对是提示词问题,召回不对才是知识库问题。