
3.5.2 数据接入
知识库的文档不一定都要手动上传:外部源让知识库自己从远端拉内容并保持更新。平台内置两类数据源——飞书源(同步飞书文档,详见 3.5.5 飞书同步)与网页爬虫(抓取网站,详见 3.5.6 网页抓取)。本章介绍两类源共享的接入机制:怎么建源、怎么同步、怎么增量。
入口在知识库详情的「外部源」页:
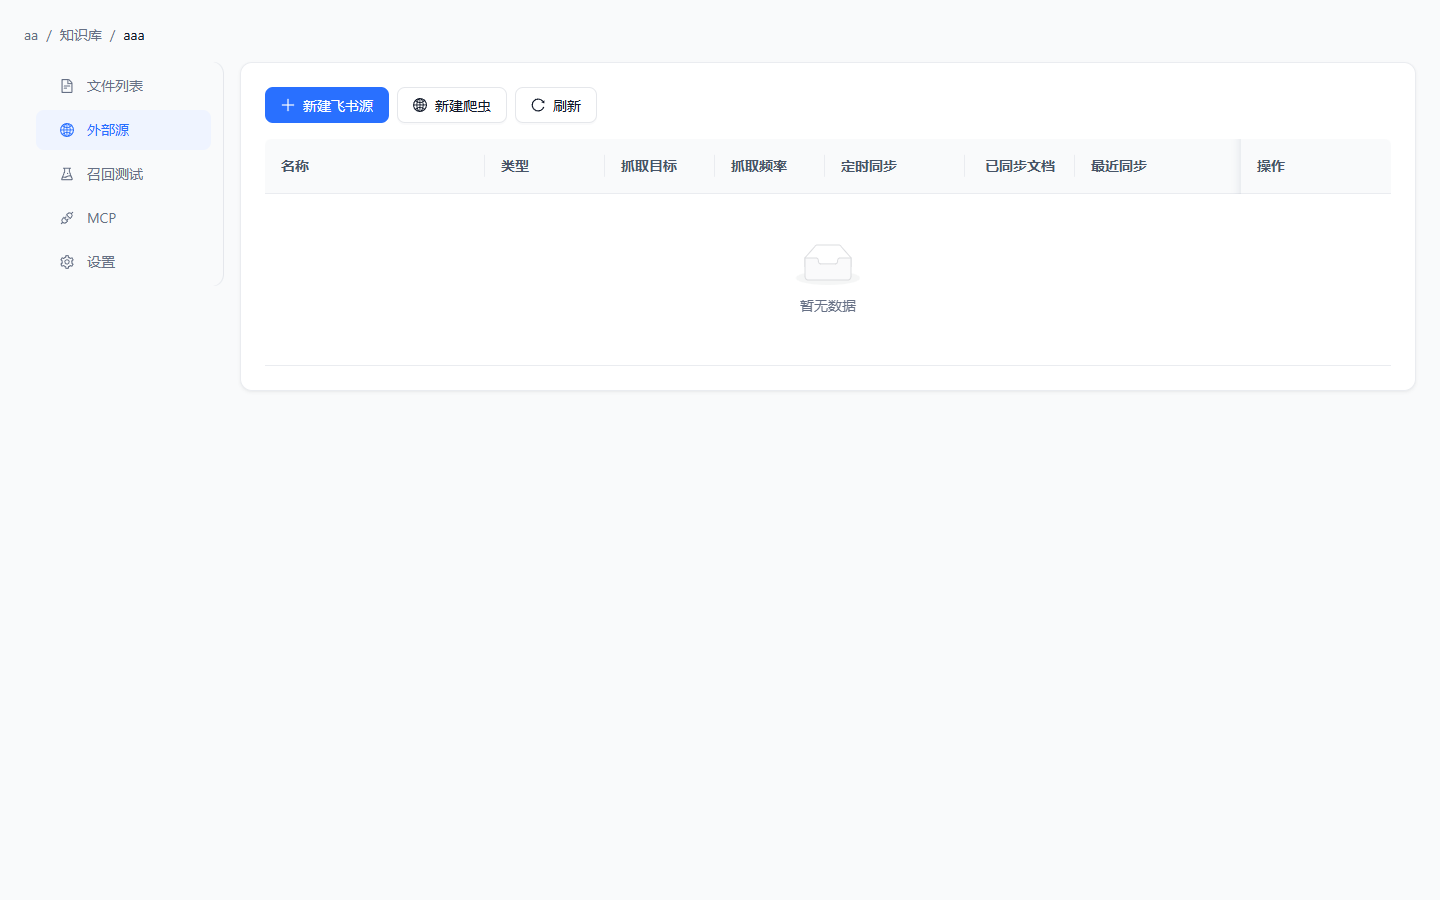
列表展示每个源的名称、类型、抓取目标、抓取频率、定时同步、已同步文档数与最近同步时间,行操作可手动同步、编辑与停用。
同步机制
每个外部源有一套统一的同步语义:
- 手动同步:随时在行操作里触发,立即执行一轮抓取/拉取;
- 定时同步:开启后按 cron 表达式在后台自动执行(表达式按 UTC 时区解释,与知识库所属时区无关);
- 增量比对:同步按内容哈希逐页比对——没有变化的跳过,有变化的更新,新出现的入库;必要时可强制全量重抓;
- 覆盖已变更页面:源上有一个同名开关——开启后,已抓取但内容变化的页面会被重新覆盖并再次触发工作流;关闭则已入库页面直接跳过,只收新页面;
- 自动加工:抓取到的新文档与变更文档,会按知识库「设置」中的默认工作流自动执行切割、元数据生成与向量化,不需要人工再处理一遍。
这套机制意味着:配好一个源 + 定时同步后,知识库可以长期自动跟随内容源演进,运维成本接近零。
网页爬虫源
点击「新建爬虫」,从起始地址出发抓取整站或指定路径:
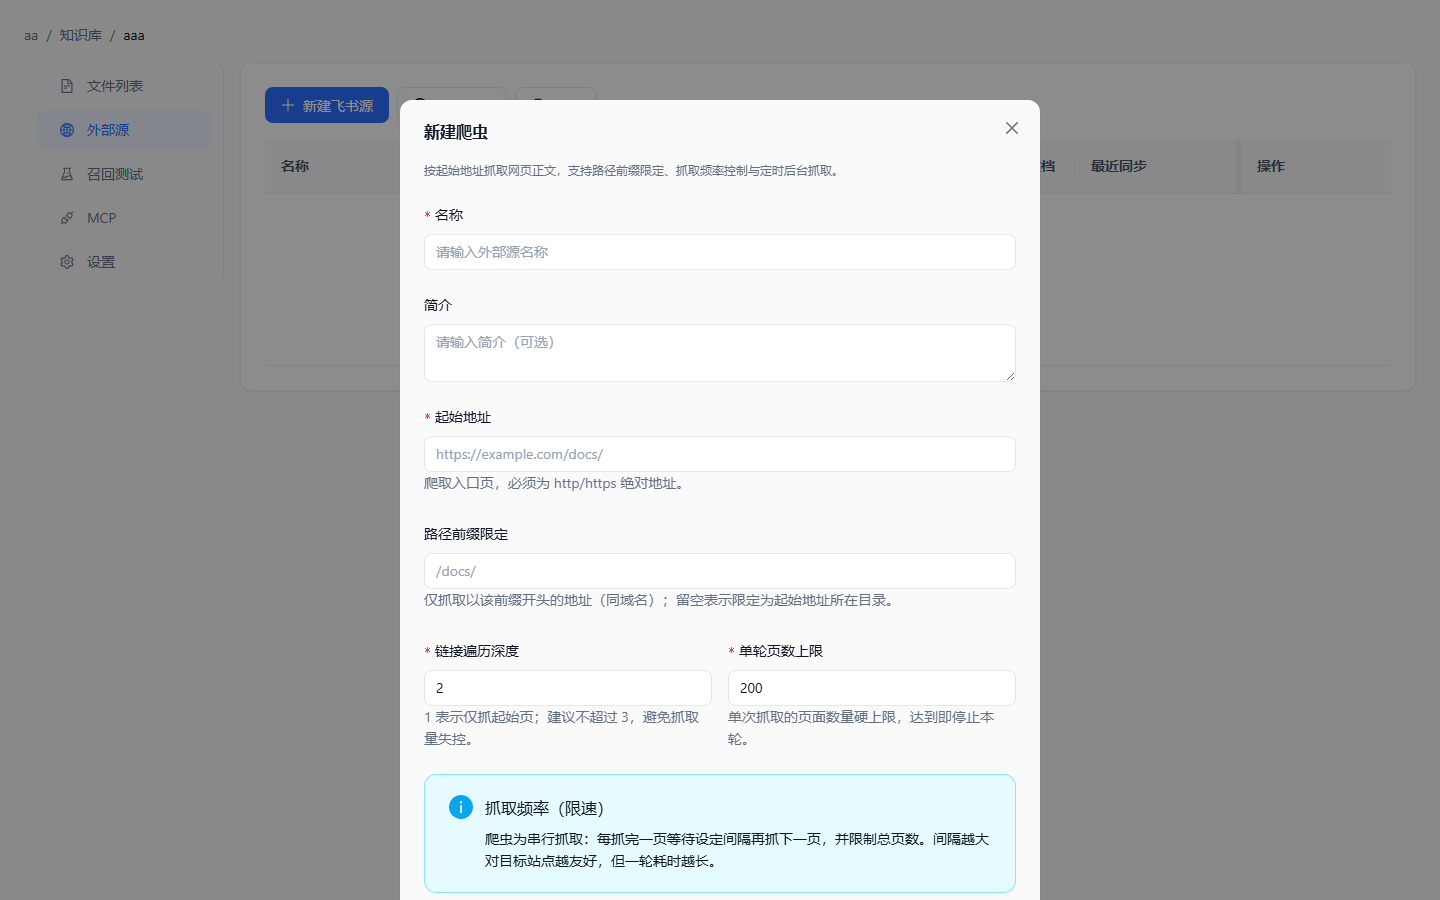
| 字段 | 说明 |
|---|---|
| 起始地址 | 抓取入口页,必须为 http/https 绝对地址 |
| 路径前缀限定 | 只抓取以该前缀开头的同域名地址;留空限定为起始地址所在目录,防止爬出目标站 |
| 链接遍历深度 | 1 表示仅抓起始页;建议不超过 3,避免抓取失控 |
| 单轮页数上限 | 单轮抓取的页面数量上限,达到即停 |
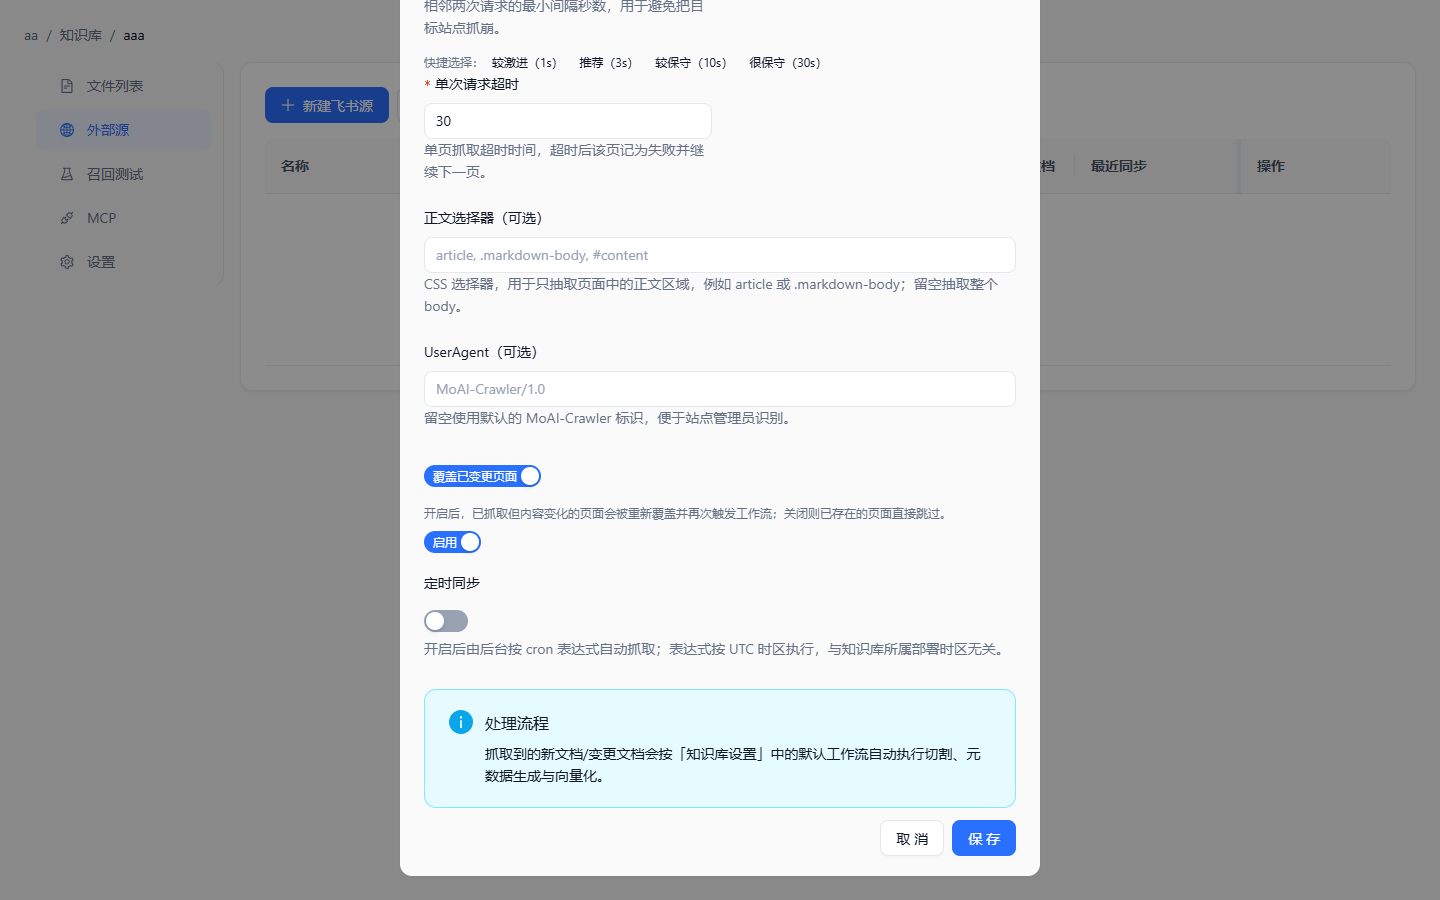
第二屏是礼貌抓取与同步策略:
- 请求间隔:串行抓取,每抓一页等待设定间隔(快捷档位 1s / 3s / 10s / 30s),间隔越大对目标站点越友好;
- 单次请求超时:超时的页面记为失败并继续下一页,不会卡住整轮;
- 正文选择器:CSS 选择器(如
article、.markdown-body),只抽取页面正文区域,过滤导航、页脚等噪音; - UserAgent:默认
MoAI-Crawler/1.0,站点管理员可据此识别; - 覆盖已变更页面 与 定时同步:见上文同步机制。
数据接入与文档管线的关系
外部源只负责「把内容拿进来」,入库后的处理与手动上传完全一致:同样的切割、元数据、向量化,文档同样出现在「文件列表」中(来源标记为外部源),召回测试、应用绑定等能力全部通用。源停用后不再同步,已入库文档保留。
案例:让帮助中心知识库自动跟随官网更新
以「云途网盘帮助中心」为例(见 3.5.1),产品文档托管在官网 docs 站点,希望知识库自动保持同步:
- 建源:在知识库「外部源」新建爬虫,起始地址填
https://docs.example.com/help/,路径前缀限定/help/,遍历深度 2、单轮上限 200; - 降噪:正文选择器填
article.markdown-body,只抽正文;请求间隔选推荐档 3s; - 自动化:开启定时同步(如每天凌晨 2 点),开启「覆盖已变更页面」;
- 验证:先手动同步一轮,到「文件列表」确认文档数量与内容,再到召回测试抽查新章节能否命中。
此后官网文档每次更新,知识库在下一轮定时同步后自动跟上,全程无需人工干预。
常见问题
爬虫抓到的页面很乱、带导航和页脚?
用正文选择器圈定正文区域;选择器需要在目标页面的 DOM 结构上核对(浏览器 F12 查一下正文容器的 class)。
定时同步没有按时执行?
cron 表达式按 UTC 时区执行,换算成本地时间核对;另外确认源处于「启用」状态。
源内容更新了,知识库里的文档没变?
检查「覆盖已变更页面」是否开启——关闭状态下已入库页面一律跳过;确认方式是看该页面的最近同步时间与文档版本。
同步会覆盖我在平台上对文档的手工修改吗?
外部源同步的文档以上游内容为准;但更新挡板会保护正在编辑的文档,避免同步覆盖未完成的修改。对入库文档做人工修订前,先确认该文档与源的同步关系。