
3.5.6 网页抓取
网页抓取源让知识库直接「吃下」一个网站:从入口 URL 出发沿链接抓取页面、抽取正文,自动走切割、元数据、向量化管线入库。文档站、帮助中心、内部 Wiki——只要内容在网页上,就能整站搬进知识库。
建源入口与公共同步机制(手动/定时同步、增量比对、更新挡板)见 3.5.2 数据接入,本章聚焦爬虫源自身的配置与调优。
抓取范围:把爬虫圈在你的目标里
爬虫最容易出的事故是「抓飞了」——从文档站爬到了官网门户、博客甚至外站。三个参数负责圈定边界:
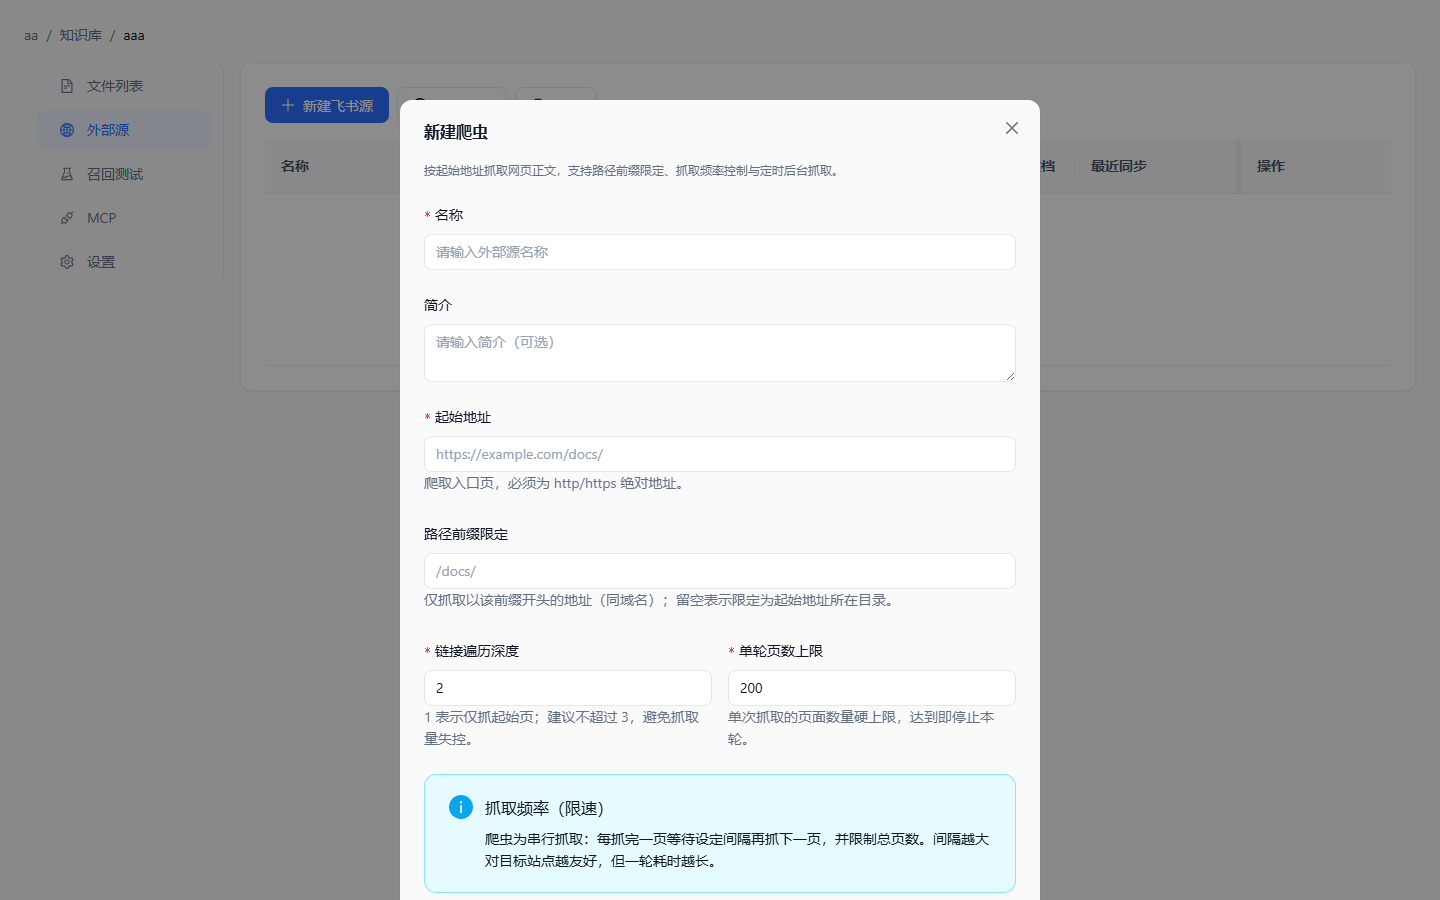
- 起始地址:入口页,http/https 绝对地址。选内容最集中的目录页(如
https://docs.example.com/help/),不要用站点首页; - 路径前缀限定:只抓取该前缀开头的同域名地址。留空时限定为起始地址所在目录,是最安全的默认;要跨目录抓取时再显式放宽;
- 链接遍历深度:1 表示只抓起始页。文档站的常见层级是「目录页 → 章节页 → 正文」,深度 2~3 足够;超过 3 通常意味着抓到了导航死循环,建议收紧而不是放宽;
- 单轮页数上限:单轮抓取的页面数量上限,达到即停。首次配置建议设小(如 50)试跑一轮,确认抓的都是目标页后再放大。
正文抽取:只要内容,不要导航
页面上的侧边栏、导航、页脚对检索是纯噪音。正文选择器用一个 CSS 选择器圈定正文容器:
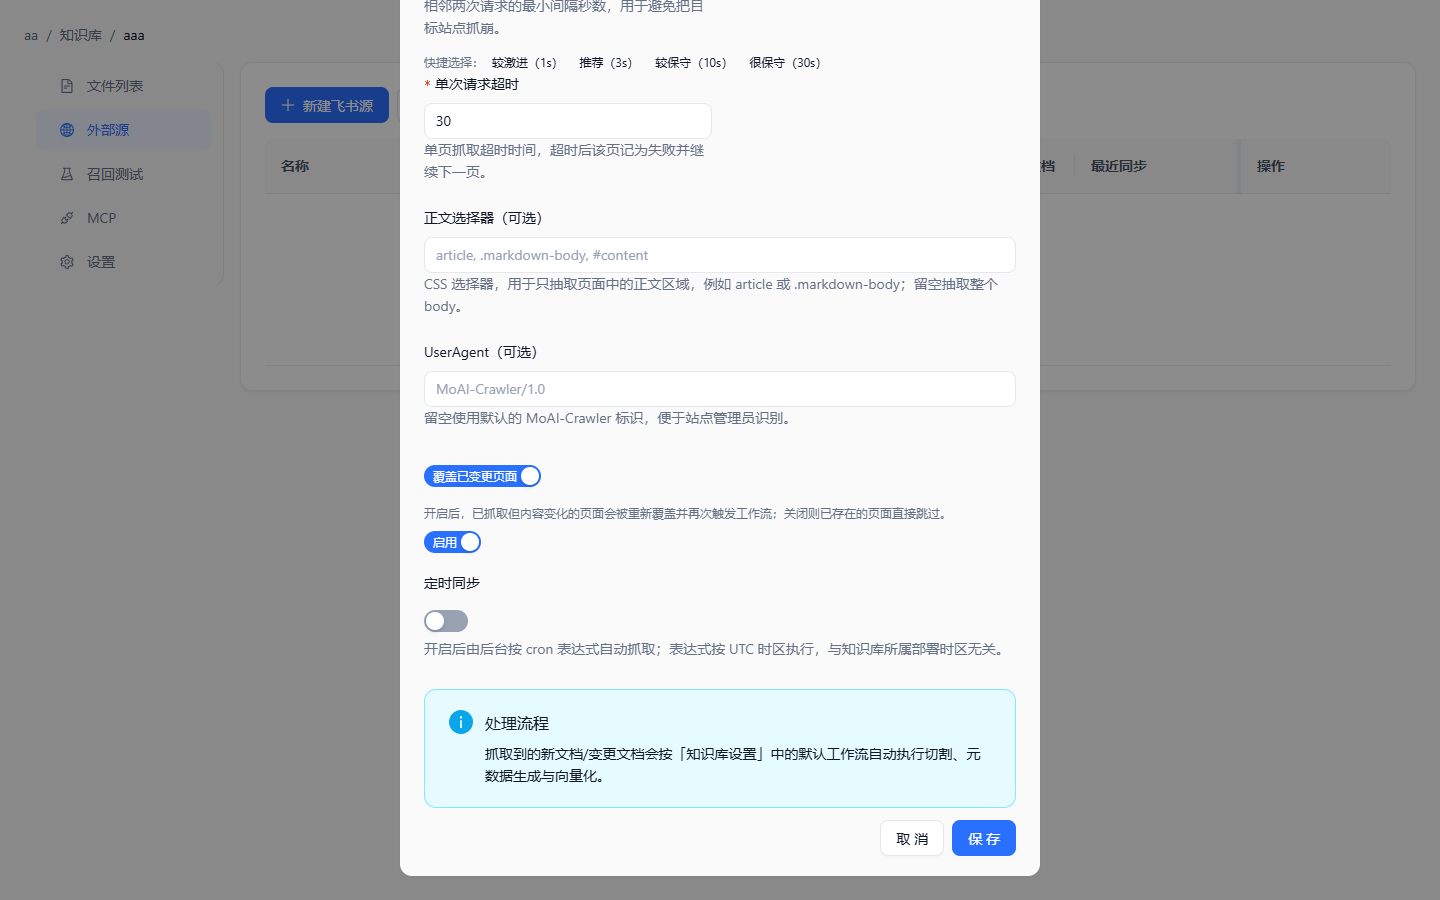
- 在目标页面按 F12,找到正文的容器元素(常见如
article、.markdown-body、#content),把选择器填进来;留空则抽取整个 body; - 同一站点页面结构一致,配置一次全站生效。
其余字段:请求间隔(串行抓取的礼貌节奏,快捷档位 1s / 3s / 10s / 30s,对第三方站点建议 3s 起)、单次请求超时(超时页面记失败并继续,不卡整轮)、UserAgent(默认 MoAI-Crawler/1.0,便于站点管理员识别)。
增量与更新策略
- 增量比对:每轮同步按内容哈希逐页比对,没变的跳过、变化的更新、新增的入库——日常同步的开销与变化量成正比,而不是与站点大小成正比;
- 覆盖已变更页面:开启后变化页面重新覆盖入库并触发工作流;关闭则已入库页面一律跳过。需要内容随时保持最新就开启;
- 父页无变化仍会发现新页面:增量比对按页进行,目录页没改不影响其下新增页被发现;
- 强制全量:正文选择器改了、或怀疑历史抓取有遗漏时,手动触发强制全量重新抓一遍。
案例:帮助中心整站入库
把 https://docs.example.com/help/ 的帮助中心搬进「云途网盘帮助中心」知识库:
- 试跑:新建爬虫,起始地址填帮助中心首页,路径前缀限定
/help/,深度 2、上限 50、间隔 3s,保存后立即手动同步一轮; - 核对:到文件列表检查这 50 个页面——都是正文页、没有登录页/标签页,正文选择器抽出的内容完整;
- 放大:上限调到 500,正文选择器填
article.markdown-body,开启覆盖已变更页面与每日凌晨定时同步; - 交付:此后帮助中心的更新在下一轮同步后自动进入知识库,客服 Agent 的回答与官网文档保持一致。
常见问题
抓回来的页面内容缺失或夹杂菜单?
正文选择器没配对:留空时抽整个 body(含导航),配错选择器会抽到空内容。F12 核对正文容器后修正,然后对受影响页面强制全量重抓。
抓取被目标站限流或封禁?
调大请求间隔、降低定时频率;确认 UserAgent 未被目标站屏蔽。持续 403/429 说明站点明确拒绝爬取,请改用官方导出或联系站点方。
动态渲染(JS 渲染)的页面抓不到内容?
爬虫抓取的是服务端返回的 HTML;重前端渲染的 SPA 站点可能抽不到正文,确认目标站直出 HTML,或寻找其文档导出口。
抓取总数一直远小于预期?
依次检查:路径前缀是否过窄、遍历深度是否不够(链接藏在更深层)、单轮上限是否提前打满、链接是否要求登录才能访问。